Tuesday, 26 March 2024

CERITA 31: Two-way Repeated Measures ANOVA (Pengukuran Berulang ANOVA 2 Hala)

 CERITA 31: Two-way Repeated Measures ANOVA (Pengukuran Berulang ANOVA 2 Hala)


Assalamualaikum dan Salam Sejahtera,

Apa khabar semua? Lama sungguh tak bersiaran. 

Hari ni kita bercerita pasal two way repeated measures ANOVA. Masa bila kita nak guna kaedah ini?

1.Bila kita nak bandingkan min antara kumpulan yang telah dipecahkan kepada 2 kumpulan tidak bersandar. Contoh kita nak ukur min bagi kumpulan bersandar yang diukur pada:


2 Pemboleh ubah tidak bersandar (IV)

 i) dua atau lebih tempoh masa yang berbeza (1 bulan, 3 bulan, dan 6 bulan). Tempoh / masa ini dikira sebagai pemboleh ubah tidak bersandar yang pertama.

ii) jenis retainer (untuk pendakap gigi); cth jenis Hawley dan Essix - Pembolah ubah tidak bersandar kedua


Kita juga berminat nak tahu adakah terdapat kesan interaksi antara 2 pemboleh ubah tidak bersandar ini. (Boleh dilihat juga melalui profile plot).


Ada beberapa andaian yang perlu dipatuhi sebelum menjalankan ujian Pengukuran Berulang ANOVA 2 Hala ini antaranya:

1. pemboleh bersandar adalah selanjar, 

2. tiada signifikan outlier, 

3. pemboleh tidak bersandar (IV) harus mempunyai sekurang-kurangnya 2 kategori, 

4. data bertaburan normal/ residual DV bertabur normal

5. kesferaan varians (sphericity), iaitu varians antara kumpulan yang diuukur haruslah sama.


Saya nak kongsikan 1 artikel yang saya jumpa, iaitu sekiranya data tidak tertabur secara normal, namun ujian sphericity adalah tidak signifikan (p>0.05, dalam kes ini kita nak nilai-p tidak signifikan bermaksud andaian sphericity dipenuhi), maka kita masih boleh proceed dengan ujian Pengukuran Berulang ANOVA 2 Hala ini.

Blanca et al. (2023)

Rujukan penuh:

Reference:

Blanca, M. J., Arnau, J., García-Castro, F. J., Alarcón, R., & Bono, R. (2023). Non-normal Data in Repeated Measures ANOVA: Impact on Type I Error and Power. Psicothema, 35(1), 21-29. https://doi.org/10.7334/psicothema2022.292

Terima kasih sudi baca, lain kali ada masa saya kongsikan lagi.


Friday, 16 December 2022

CERITA 30: Analisis Regresi Logistik Binomial (binary logistic regression analysis)


CERITA 30: Analisis Regresi Logistik Binomial (binary logistic regression analysis)


Regresi logistik binomial digunakan untuk meramalkan pembolehubah bersandar dikotomi (terbahagi kepada 2 kategori) berdasarkan satu atau lebih pembolehubah bebas selanjar atau nominal. Ia adalah jenis regresi logistik yang paling biasa dan selalunya dirujuk sebagai regresi logistik. Bahasa paling mudah, regresi logistik binomial ni bezanya dengan analisis regresi berganda/ mudah adalah bergantung pada pemboleh ubah bersandarnya yg mempunyai hanya 2 kategori.

Dalam erti kata lain, masa bila kita nak guna regresi logistik binomial ni? Apabila kita lihat pemboleh ubah bersandar (y) mempunyai 2 kategori, seperti (hidup / mati), (ya / tidak), (lulus / gagal) , (merokok/ tidak merokok), dan sebagainya. Dalam spss, lazimnya pemboleh ubah yang kita minat untuk ramal atau kaji adalah kebarangkalian orang yang lulus/hidup/merokok  ini dikod sebagai 1, manakala pemboleh ubah satu lagi dikod sebagai 0.


Untuk menganalisis menggunakan kaedah ini dalam SPSS, pergi ke Analyze > Regression > Binary Logistic.

Masukkan pemboleh ubah bersandar (y) dalam kotak ‘dependent’, pemboleh ubah tidak bersandar (x) dalam kotak ‘covariates’. Di sini saya menggunakan SPSS versi 27, seperti berikut:


Sekiranya pemboleh tidak bersandar kita terdiri daripada pemboleh ubah nominal seperti kategori umur (umur< 18 thn atau umur >18 thn), kategori tahap pendidikan ( SPM, ijazah, master, phd), maka klik kotak ‘categorical’ untuk memberitahu spss bahawa ini adalah pemboleh ubah nominal. Kemudian pilih sama ada kategori yang dikod sebagai paling rendah untuk menjadi ‘reference category’ atau sebagainya.

Contohnya bagi kategori umur  (umur < 18 thn =1, atau umur >18  thn = 2), jika kita pilih reference category sebagai ‘last’, maka umur >18  thn = 2, akan dijadikan sebagai rujukan dalam analisis. Bila nak interpret nanti, kita harus laporkan umur >18 thn sebagai rujukan, apabila membuat perbandingan dengan umur < 18 thn. Jadi ini bergantung pada pengkaji itu sendiri untuk memilih reference category yg mana.


Kemudian pada kotak ‘options’ klik pada ‘hosmer-lemeshow goodness of fit’ dan ‘CI for exp(B)’ untuk output nanti. Selepas itu, klik ok.

Output pada Block 0 menunjukkan model yang hanya mempunyai intercept/ constant sahaja. Untuk result dalam laporan, kita rujuk output pada Block 1, iaitu model yang ada semua faktor/pemboleh ubah tidak bersandar.

Output pada ‘Omnibus tests of model coefficients’, menerangkan sama ada model keseluruhan kita apabila dimasukkan kesemua faktor adalah signifikan iaitu lebih baik berbanding model asas yang tidak dimasukkan faktor. 

Omnibus Tests of Model Coefficients


Chi-square

df

Sig.

Step 1

Step

3.957

1

.047

Block

3.957

1

.047

Model

3.957

1

.047

Berikut adalah penerangan yang boleh dibuat:

Omnibus Tests of Model Coefficients shows that overall model are statistically significant when compared to the null model, χ2(1) = 3.957, p = 0.047.

Pada jadual ‘model summary’, kita berminat untuk melihat nilai pada Cox & Snell R2 dan Nagelkerke R2. Kedua-dua nilai ini boleh dilaporkan seperti R2 dalam analisis regresi yang biasa. Semakin hampir nilai Cox & Snell R2 dan Nagelkerke R2 kepada 1, semakin tinggi peratus variation dalam pemboleh bersandar dapat diterangkan oleh pemboleh ubah tidak bersandar.

Akhir sekali pada ‘variables in the equation’, adalah untuk melihat kesan setiap pemboleh ubah tidak bersandar terhadap model, iaitu dengan melihat nilai signfikan (sig). Sekiranya pemboleh ubah tidak bersandar adalah selanjar, boleh laporkan secara terus samada signfikan atau tidak. Bagi pemboleh ubah tidak bersandar yang nominal seperti umur tadi  (umur < 18 thn =1, atau umur >18  thn = 2), kategori rujukan (umur >18  thn = 2) kita perlu laporkan, odds untuk responden mendpt penyakit xx (cth) adalah 1.026 (nilai ini merujuk pada Exp(B) lebih tinggi bagi responden umur < 18 thn berbanding umur >18 thn.

Sekian dahulu, terima kasih.

Monday, 9 May 2022

CERITA 29: Panduan Ketika Menjalankan Analisis Faktor Penerokaan (Exploratory Factor Analysis - EFA)

CERITA 29: Panduan Ketika Menjalankan Analisis Faktor Penerokaan (Exploratory Factor Analysis - EFA)

Assalamualaikum semua pembaca, berikut saya kongsikan lagi sedikit panduan berkenaan Analisis Faktor Penerokaan/Penjelajahan (Exploratory Factor Analysis – EFA). Sebelum ini saya pernah tulis juga pasal EFA, boleh rujuk di sini CERITA 19  dan  CERITA 27

  1. Komunaliti (Communality) – Nisbah/kadar varians bagi sesuatu item yang dapat diterangkan oleh faktor tersebut. Dinasihatkan untuk membuang item yang mempunyai nilai komunaliti kurang daripada 0.20 (Child, 2006)

      2.    Terdapat 2 kaedah dalam EFA (Field, 2013) :

ü  Principal Axis Factoring – jika kita gunakan sampel kajian kita untuk analisis selanjutnya

ü  Maximum Likelihood / Kaiser’s alpha factoring – jika kita nak bangunkan instrument dan instrument tersebut akan digunakan untuk data set lain pada masa akan datang

       3.     Hadkan nilai pemberat faktor (factor loading) kepada 0.30. Item yang kurang daripada 0.30                     seharusnya digugurkan. Pemberat factor yang melebihi 0.40 dikatakan stabil (Guadagnoli dan                 Velicer, 1988).


Rujukan:

Child, D. (2006). The Essentials of Factor Analysis. 3rd edn. New York: Continuum.

Field, A. (2013) Discovering Statistics using SPSS, 4th edn. London: SAGE. Guadagnoli, E. and Velicer,

W. F. (1988) Relation of sample size to the stability of component patterns. Psychological Bulletin, 103(2), pp. 265-275.


Friday, 23 April 2021

CERITA 28: Kaedah untuk Penilaian Kesahan Diskriminan (discriminant validity)

CERITA 28: Kaedah untuk Penilaian Kesahan Diskriminan (discriminant validity)

Kaedah untuk penilaian kesahan diskriminan (discriminant validity)

Assalamualaikum semua pembaca, salam 12 Ramadhan. Hari ini saya nak kongsikan beberapa kaedah yang boleh digunakan untuk menilai kesahan diskriminan sebelum kita proceed dengan Persamaan Pemodelan Berstruktur (SEM).

Takrifan:

Kesahan diskriminan yang menunjukkan model pengukuran sesuatu konstruk bebas daripada item yang bertindih (Pallant, 2016).

Kesahan diskriminan merujuk kepada sejauh mana sesuatu konstruk yang diukur benar-benar berbeza daripada konstruk yang lain, serta sejauh mana sesuatu item itu hanya mewakili satu konstruk pendam sahaja (Hair et al. 2014). 

Ujian kesahan diskriminan yang dicadangkan oleh Hair et al. adalah dengan menggunakan:

1. kaedah bebanan silang (cross-loadings),

2. kriteria Fornell-Larcker

3. nisbah korelasi Heterotrait-Monotrait (HTMT).


Menggunakan mana-mana kaedah ini, konstruk-konstruk model telah memenuhi kesahan diskriminan yang telah ditetapkan apabila:

 1. Kaedah bebanan silang (cross-loadings),

The factor loading indicators on the assigned construct have to be higher than all loading of other constructs with condition that the cut-off value of factor loading is higher than 0.70 (Hair et al. 2011; Hair et al. 2014).

2. Kriteria Fornell-Larcker

Disemak dengan membuat perbandingan korelasi antara konstruk dengan nilai punca kuasa dua AVE bagi setiap konstruk (Fornell & Larcker 1981; Zainudin 2016). Kesahan diskriminan dikatakan tercapai apabila nilai punca kuasa dua AVE adalah lebih besar daripada nilai korelasi antara konstruk mengikut baris dan lajur bagi konstruk berkenaan.

3. Nisbah korelasi Heterotrait-Monotrait (HTMT) 

Nilai nisbah korelasi bagi HTMT bagi kesemua konstruk adalah tidak melebihi 0.85 iaitu nilai kritikal yang diperlukan bagi ujian kesahan diskriminan (Clark dan Watson, 1995; Kline, 2011; Henseler et al. 2015)  

Terdapat lagi pelbagai kaedah lain, pembaca sendiri boleh explore. Namun kaedah 'kriteria Fornell-Larcker' paling biasa digunakan.                                                                                                              

Pengalaman saya, anda boleh cuba kaedah Fornnell-Lacker dahulu, jika masih tak dapat penuhi kesahan diskriminan , boleh cuba kaedah nisbah korelasi Heterotrait-Monotrait (HTMT). Semoga berjaya. 😄 


SEKIAN SEMOGA BERMANFAAT ..

Rujukan:

Clark, L. A., & Watson, D. (1995). Constructing validity: basic issues in objective scale development. Psychological Assessment, 7(3), 309–319.

Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2014). Multivariate data analysis. In Harlow : Pearson Education Limited. https://doi.org/10.1002/9781118895238.ch8

Kline, R. B. (2011). Principles and practice of structural equation modeling. New York: Guilford Press.

Henseler, Jörg & Ringle, Christian & Sarstedt, Marko. (2015). A New Criterion for Assessing Discriminant Validity in Variance-based Structural Equation Modeling. Journal of the Academy of Marketing Science. 43. 115-135. 10.1007/s11747-014-0403-8. 

Sunday, 17 January 2021

CERITA 27: Analisis Faktor Penjelajahan (Exploratory Factor Analysis)- EFA

 CERITA 27: Analisis Faktor Penjelajahan (Exploratory Factor Analysis)- EFA


Assalamualaikum, apa khabar semua pembaca, salam PKP 2.0. Sama-sama kita berdoa agar wabak Covid-19 segera berakhir.

Kali ni saya nak sambung cerita pasal Analisis Faktor Penjelajahan (Exploratory Factor Analysis)- EFA. Ada yang dalam BM ditulis Analisis Faktor Penerokaan. 

Entry sebelum ini saya pernah berkongsi berkenaan kaedah putaran dalam EFA. Boleh rujuk balik di SINI.

Hari ni saya nak sambung lagi cerita pasal article yang saya baca ini ditulis oleh Yong (2013). Kalau rajin boleh baca. Cuma nak ringkaskan beberapa penemuan:

Selepas kita buat rotated component matrix, dan lihat keputusan tersebut, jika ada 2 item sahaja dalam 1 faktor, berikut pandangan dalam artikel ini:

  • Sesuatu faktor itu boleh dikatakan sebagai faktor sekiranya ia mempunyai sekurang-kurangnya tiga item (Tabahnick & Fidell, 2007)
  • Secara umumnya, faktor terputar yang mempunyai dua item atau kurang perlu diterjemahkan dengan lebih berhati-hati.
  • Faktor yang mempunyai dua item di dalamnya dikatakan boleh dipercayai sekiranya ia berkorelasi tinggi antara satu sama lain (r > 0.70) dan berkorelasi sederhana dengan item yang lain (Yong, 2013).

Jadi maksudnya, kalau syarat ke-3 tu tak penuhi, bolehlah kita pertimbangkan untuk gugurkan kedua-dua item tu.


Nilai komunaliti (communalities)

Nilai communalities item juga harus kita pertimbangkan. Pemboleh ubah/ item dengan nilai communalities yang rendah (< 0.20) seharusnya digugurkan (Child, 2006).


Pengekstrakan faktor

Ada beberapa kaedah, tetapi 3 kaedah yang biasa digunakan adalah:

1) Maximum likelihood (kebolehjadian maksimum) : lebih berguna untuk analisis faktor pengesahan (CFA) dan digunakan untuk menganggar pemberat  faktor untuk populasi.

2) Principal Axis Factor : dengan kefahaman bahawa kesemua pemboleh ubah berada pada faktor pertama. Apabila faktor diekstrak, matriks ralat diukur. Faktor kemudiannya diekstrak secara berterusan sehingga terdapat sejumlah besar varians yang dikira dalam matriks korelasi (Tucker & MacCallum, 1997). Kaedah ini lebih sesuai sekiranya data tidak mengikuti andaian taburan multivariat normal (multivariate normality assumption)

3) Principal component : Merupakan teknik pengurangan data. Kaedah ini digunakan untuk mengekstrak varians maksimum daripada data daripada setiap komponen, maka ia mengurangkan sejumlah besar pemboleh ubah kepada komponen yang lebih kecil (Tabachnick & Fidell, 2007).


Ok, sampai di sini dahulu. Sebenarnya banyak nak cerita pasal EFA ni lagi, tp tunggu ada kesempatan saya update lagi.


Semoga bermanfaat. Terima kasih.


Rujukan:

Tabachnick, B. G., & Fidell, L. S. (2007). Using multivariate statistics (5th ed.). Boston, MA: Allyn & Bacon. 

Tucker, L.R., & MacCallum, R.C. (1997). Exploratory factor analysis. Retrieved March 27, 2012 from http://www.unc.edu/~rcm/book/ch7.pdf

Yong AG, Pearce S. A beginner’s guide to factor analysis: focusing on exploratory factor analysis. Tutorials in Quantitative Methods for Psychology 2013; 9(2):79–94

Saturday, 21 March 2020

CERITA 26: Indeks Kesepadanan Persamaan Pemodelan Berstruktur (Fit Indices SEM)

CERITA 26: Indeks Kesepadanan Persamaan Pemodelan Berstruktur (Fit Indices SEM)

Salam semua pembaca, alhamdulillah berjumpa lagi di tahun 2020.

Saya nak kongsikan paper ini berkenaan panduan dalam menentukan model fit dalam SEM.


Boleh baca di sini: http://www.stats.ox.ac.uk/~snijders/mpr_Schermelleh.pdf


Rujukan

Schermelleh-Engel, K., Moosbrugger, H., & Müller, H. (2003). Evaluating the fi t of structural equation models: Tests of signifi cance and descriptive goodness-of-fi t measures. Methods of Psychological Research Online, 8, 23–74


Tuesday, 17 September 2019

CERITA 25: Ujian Levene signifikan? (Significant Levene Test)

CERITA 25: Ujian Levene signifikan? (Significant Levene Test)


Apa itu Ujian Levene? Ujian ini diperkenalkan oleh Profesor Howard Levene pada tahun 1960, di mana selepas itu ujian ini dikatakan sebagai penemuan yang hebat sehingga kajiannya masih lagi dijadikan rujukan sehingga kini, melebihi separuh abad lamanya. Ini kerana ujian Levene dikatakan teguh (robust) terhadap data yang tidak mengikuti taburan normal.
Beliau meninggal dunia pada Julai 2003. Boleh baca artikel lanjut tribute kepada beliau di SINI.


Ujian Levene digunakan apabila pengkaji ingin menggunakan ujian parametrik seperti ujian- t , ANOVA dan sebagainya. Sebelum ujian tersebut digunakan, pengkaji terlebih dahulu perlu menyemak samada andaian kehomogenan (kesamaan) varians adalah dipenuhi.

Hipotesis dalam ujian Levene ditakrifkan seperti berikut:

Hipotesis nol: varians adalah homogen
Hipotesis alternatif: varians adalah tidak homogen

Nilai-p dalam ujian Levene seharusnya tidak signifikan (nilai-p > 0.05), iaitu membolehkan hipotesis nol diterima. Ini bermaksud andaian kehomogenan varians dipenuhi. Maka kita dapat teruskan dengan ujian t /ANOVA.

Tetapi bagaimana pula jika nilai-p adalah signifikan bagi Ujian Levene tadi? Jangan risau, kerana ada ujian alternatif kita dapat gunakan iaitu Welch test (Delacre et al 2017)

Cara untuk run adalah seperti berikut : Analyze > Compare mean > 1 way ANOVA > Options > Statistics 'Welch' > OK.

Apabila keluar jadual output, guna nilai 'sig.' untuk interpret data anda.

Selamat mencuba.


Rujukan:
Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of student's t-test. International Review of Social Psychology, 30(1), 92-101. DOI: 10.5334/irsp.82

Gastwirth, J.L., Yulia, G. R., and Miao, W. (2009). The Impact of Levene’s Test of Equality of Variances on Statistical Theory and Practice. Statist. Sci.Volume 24, Number 3 (2009), 343-360.

Tuesday, 23 April 2019

CERITA 24: R square(R kuasa dua) dalam analisis regresi

CERITA 24: R square (R kuasa dua) dalam analisis regresi


Salam, hari ni kita bercerita sedikit tentang R squared.

R squared, (R2 = R kuasa dua) adalah peratus varians dalam pemboleh ubah bersandar (dependent variable) yang diterangkan oleh pemboleh ubah tidak bersandar (independent variable) dalam model regresi. R square adalah ukuran statistik yang menunjukkan bagaimana data terletak hampir dengan garis regresi yang dipadankan. Nilai R square adalah di antara 0 – 1, atau bila diterjemahkan dalam bentuk peratus, antara 0-100%.

R square juga dikenali dengan nama coefficient of determination.

Secara amnya, semakin tinggi nilai R square, semakin bagus data berpadanan dengan model. Namun, sebelum kita bergantung pada nilai R square ini, beberapa diagnostik lain harus disemak terlebih dahulu untuk mengelakkan dapatan analisis yang tidak tepat.


Rumus bagi R squared adalah seperti berikut:


Gambaran visual berkenaan R square


Sumber: google


R squared untuk model regresi di sebelah kiri adalah 38% manakala di sebelah kanan adalah 87.4%. Semakin tinggi varians yang dikira oleh model regresi, semakin hampir poin-poin data akan terletak berdekatan garis regresi yang dipadankan.

Adakah nilai r square yang rendah membawa implikasi yang buruk? Tidak, kerana ada beberapa sebab mengapa nilai yang rendah dalam kajian dikatakan ok sahaja. Dalam sesetengah bidang, adalah dijangka bahawa nilai R square adalah rendah. Contohnya bidang yang cuba untuk meramal tingkahlaku manusia, seperti kajian psikologi, lazimnya akan mendapat nilai R square yang kurang daripada 50%. Ini kerana dikatakan manusia adalah lebih sukar untuk diramal, berbanding dengan sesuatu proses fizikal.

Ok sekian sahaja untuk kali ini. Ada cerita dan masa saya kongsi lagi. Terima kasih sudi membaca.

Wednesday, 9 January 2019

CERITA 23: Boxplot (plot kotak) untuk mengenalpasti data terpencil (outliers) bagi data univariat

CERITA 23: Boxplot (plot kotak) untuk mengenalpasti data terpencil (outliers) bagi data univariat


Assalamualaikum dan selamat tahun baharu 2019 kepada sahabat pembaca semua!

Hari ini saya nak kongsikan kaedah untuk mengenalpasti outliers (data terpencil) dalam data univariat (1 pembolehubah). Kalau ikut article dalam ni, kesemuanya ada 39 teknik termasuk univariat dan multivariat (pengsann) kalau anda rajin nak baca bolehlah refer Aguinis et al (2013)

Sebenarnya terdapat pelbagai kaedah digunakan untuk mengenalpasti outlier, salah satu kaedah adalah menggunakan boxplot.

Boxplot (plot kotak)

Sumber: Google


Tukey (1977) memperkenalkan kaedah grafik dipanggil boxplot untuk meringkaskan data univariat.  Menurut Tukey (1977), menyatakan bahawa suatu cerapan itu ditakrifkan sebagai terpencil jika ia terletak di luar selang ini menggunakan rumus:


((Q1 - g (Q3 - Q1), Q3 + g (Q3 - Q1))

di mana g yang lazim digunakan dalam rumus ini adalah 1.5.


Ada juga artikel yang menggunakan g sebagai 3.0. Namun menurut Hoaglin et al (1986), peraturan boxplot dengan g = 1.5 ini adalah agak liberal untuk kebanyakan cerapan yang normal.

Untuk mencari outliers bagi satu pembolehubah menggunakan SPSS,

 Analyze > Descriptive > Explore > Dependent list (masukkan pembolehubah berkenaan) > Klik Statistics > pilih Outliers dan percentiles > klik ‘continue’


Pada output, rujuk jadual ‘percentiles’, refer pada baris ‘weighted average’ dan lajur ‘25’ percentiles dan lajur ‘75’ percentiles.

  •       Lajur ‘25’ percentiles adalah nilai Q1 kita
  •       Lajur 75’ percentiles adalah nilai Q3 kita.


Manakala nilai g adalah 1.5

Menggunakan rumus  ((Q1 - g (Q3 - Q1), Q3 + g (Q3 - Q1)),

Cari nilai had bawah dan nilai had atas bagi pembolehubah tersebut. Di mana;


  • Nilai had bawah = Q1 - g (Q3 - Q1), katalah nilai had bawah = a
  • Nilai had atas = Q3 + g (Q3 - Q1), katalah nilai had atas = b


Maka, menggunakan teknik peraturan 1.5 julat antara kuartil (1.5xIQR rules) ini, maka nilai < a dan nilai yang > b adalah outliers dalam data tersebut.

Bagi mengenalpasti case id yang mempunyai nilai outliers ini, kita boleh refer pada output , jadual bertajuk ‘extreme values’. ‘Highest’ merujuk pada nilai ekstrim pada had atas, manakala ‘lowest’ merujuk pada nilai ekstrim pada had bawah. Menggunakan kaedah ini, kita dapat kenal pasti case id yang dikenalpasti sebagai outliers iaitu yang terletak pada nilai < a dan nilai yang > b.


Sekian, ada cerita dan masa saya kongsi lagi. TQ sudi membaca!


Rujukan:

Hoaglin, D. C., and Iglewicz, B. (1987), “Fine Tuning Some Resistant Rules for Outlier Labeling”, Journal of American Statistical Association., 82, 1147-1149.

Tukey, J.W. (1977), Exploratory Data Analysis, Reading, MA: Addison-Wesley. 


Saturday, 11 August 2018

CERITA 22: Crosstab dan hubungan antara dua pembolehubah nominal (Chi square)

CERITA 22: Hubungan (korelasi) antara dua pembolehubah (Chi square)

Assalamualaikum semua pembaca yang dihormati, topik ni dah lama simpan baru ada kesempatan untuk menulis.

Tabulasi silang (crosstabulation) 

Tabulasi silang (crosstabulation) adalah  satu jadual yang terdiri daripada beberapa kumpulan frekuensi bagi  beberapa pemboleubah.

Contoh kita nak tahu adakah pesakit patuh terhadap prosedur rawatan dialisis (Ya/Tidak) mengikut tahap pendidikan (SPM/Diploma/Ijazah)?

Di sini kita ada dua pembolehubah iaitu :
1. Kepatuhan terhadap prosedur rawatan (2 kategori)
2. Tahap pendidikan (3 kategori)

Maka daripada data yang kita ada, kita boleh bina jadual tabulasi silang di SPSS dengan klik Analyze> Descriptive Statistics > Crosstabs > Cells > Observed > Percentage (row) > OK

Maka terhasillah jadual tabulasi silang kita.


Statistik Khi Kuasa Dua (Chi-square statistics)

Digunakan apabila kita hendak mengetahui hubungan antara dua pembolehubah nominal, contoh seperti di atas, kita hendak tahu adakah terdapat hubungan antara kepatuhan dengan latar belakang pendidikan.

Berikut hipotesis kita:

Hipotesis null: Tiada hubungan antara kepatuhan dan latar belakang pendidikan
Hipotesis null: Terdapat hubungan antara kepatuhan dan latar belakang pendidikan


Maka lanjutan dari kaedah tadi;

Analyze> Descriptive Statistics > Crosstabs > Cells > Observed > Percentage (row)

Klik Statistics > Chi square and Phi Cramer's V > OK


Untuk melihat samada terdapat hubungan atau tidak, dalam jadual 'Chi-square test', kita melihat pada baris 'Pearson Chi Square' dan kemudian pada nilai 'asymptotic significance'. Jika nilai tersebut < 0.05, maka kita tolak hipotesis null dan ini bermaksud terdapat hubungan antara dua pembolehubah tersebut.

Sekiranya terdapat hubungan, selanjutnya kita lihat jadual 'Symmetric measures' dan nilai Phi dan Cramer's V digunakan untuk melihat kekuatan hubungan antara dua pembolehubah tersebut dan bolehlah kita tafsirkannya sebagai hubungan positif/negatif yang (sangat lemah, lemah, sederhana, kuat, sangat kuat)

Catatan/ Amaran: OK, sebenarnya ada beberapa assumptions yang kita perlu patuhi sebelum boleh guna chi square ni, antara yang saya nak highlight di sini adalah, dalam jadual crosstabulation tadi, setiap expected frequency harus tidak kurang daripada 5! Jadi anda perlu hati-hati  terutama jika bilangan sampel anda kecil! Lazimnya berdasarkan pengalaman saya, kes ini banyak dalam bidang perubatan/klinikal. Jika tidak anda tak boleh guna ujian ini, antara alternatif lain yang boleh dipertimbangkan adalah untuk menggunakan Ujian Fisher Exact Test dll.

Sekian dulu untuk kali ini. Ada cerita saya kongsi lagi. Terima kasih sudi membaca.

Sunday, 27 May 2018

CERITA 21: Analisis Kebolehpercayaan Cronbach Alpha (Reliability Analysis)


Analisis Kebolehpercayaan Cronbach Alpha (Reliability Analysis)


sumber: google
Salam semua. mcm biasa gambar di atas tiada kaitan. hehe. ok kali ni nak cerita pasal Cronbach Alpha.

Pekali Cronbach Alpha (α), yang dihasilkan oleh Lee Cronbach pada tahun 1951, digunakan untuk mengukur kebolehpercayaan, atau konsistensi dalaman. "Kebolehpercayaan" adalah sejauh mana ujian itu mengukur sesuatu konstruk. Sebagai contoh, sebuah syarikat telekomunikasi ingin membuat kaji selidik kepuasan pelanggan.

Kebolehpercayaan yang tinggi bermakna item-item di dalam survei tersebut benar-benar mengukur kepuasan pelanggan, manakala kebolehpercayaan yang rendah bermakna ia mengukur sesuatu yang lain daripada kepuasan pelanggan.


Ujian Cronbach Alpha dijalankan untuk melihat adakah soalan kaji selidik yang diukur melalui skala likert itu boleh dipercayai. Soalan-soalan ini mengukur pemboleh ubah pendam (latent) - pembolehubah yang tersembunyi atau tidak dapat diukur secara terus seperti: bersifat terbuka, personaliti atau bertanggungjawab.

Cara untuk dapatkan nilai cronbach alpha:

Di SPSS : Analyze à Scale à Reliability Analysis à masukkan item-item di bawah faktor/ dimensi yang hendak diuji à Click Statistics à tick  ‘descriptives for’ scale if item deleted à OK

Secara umumnya, nilai pekali kebolehpercayaan > 0.7 adalah diterima dalam kajian dan menunjukkan item-item dalam soalan adalah boleh dipercayai. 

'Cronbach alpha if item deleted' dalam jadual output memberikan kita panduan untuk menaikkan nilai cronbach alpha dengan membuang item-item tertentu.

Manakala 'Corrected item total correlation' pula memberi panduan kepada kita sekiranya nilai < 0.3 maka item tersebut harus disemak semula kerana ia mempunyai hubungan korelasi yang amat rendah dengan item-item yang lain.

Isu dalam cronbach alpha:
1) jika nilai cronbach alpha terlalu tinggi, ada kemungkinan item-item kita mempunyai korelasi yang tinggi antara 1 sama lain (untuk ini issue multicollinearity mungkin terjadi jika buat regression/ SEM nanti. Cadangan untuk membuang item yang tidak perlu

2) Namun perkara (1) juga mungkin boleh terjadi sekiranya bilangan item kita adalah banyak, ini kerana formula dalam cronbach alpha itu sendiri

3) nilai cronbach alpha yang rendah berkemungkinan item-item kita tidak mengukur apa yg sepatutnya diukut (semak kembali soalan kita). Juga kemungkin bilangan item terlalu sedikit juga boleh diambil kira sebagai faktor. 


ok , pembaca budiman kalau nak tahu lebih lanjut pasal cronbach alpha boleh baca di sini Tavakol & Dennick (2011)


Sekian ada cerita saya kongsi lagi..

Thursday, 29 March 2018

CERITA 20: Nak buat EFA (Exploratory Factor Analysis) atau CFA (Confirmatory Factor Analysis)?


SUMBER: Google


Salam semua pembaca, antara persoalan yang hangat juga ni, masa bila kita perlu buat EFA (Exploratory Factor Analysis) atau CFA (Confirmatory Factor Analysis)?

Ok biar saya ringkaskan ikut pemahaman saya berdasarkan pembacaan, tak sempat nak 'cite' dari reference mana, jika ada kelapangan saya akan 'cite'.

...
Bila perlu buat EFA?

Lazimnya EFA kita buat untuk menentukan dimensi item yang diukur, Juga kita buat EFA untuk explore struktur faktor dalam pembolehubah kajian.
.
Sekiranya pengkaji terlibat dalam membangunkan/membina item sendiri/ adaptasi dan ubahsuai sedikit daripada literature, maka sewajarnya buatlah EFA. EFA ni guna data daripada pilot study (minimum 100 sampel- namun ada rules of thumb mengenai EFA ini, sila baca dahulu), mungkin sesuai bagi kes anda.
.
Jadi, berdasarkan keputusan EFA kita di atas tadi, item telah distrukturkan mengikut komponen. Berdasarkan kaedah ini, kita dapat saring item-item yang benar-benar diperlukan.
.
Buang item yang tak berkenaan.
.
Selepas tu, edar kembali soal selidik dan kita boleh teruskan analisis kita (data ini adalah data sebenar, bukan lagi data pilot study).
.
Selepas itu kalau nak run CFA, terpulang.

...

Bilakah tak perlu EFA?

Ok. Jika struktur faktor kita dah tahu, maka kita boleh terus buat CFA, di mana tujuan CFA adalah untuk confirmkan bahawa data kajian kita fit kepada model yang dihipotesiskan dalam konteks kajian tersebut.
.
Sekian, ada masa saya share lagi. TQ sudi membaca.

Monday, 25 December 2017

CERITA 19: Putaran dalam Analisis Faktor: Varimax atau Promax? (Rotation in Factor Analysis: Varimax or Promax)

CERITA 19: Putaran dalam Analisis Faktor: Varimax atau Promax?

Image result for forest and lake
Sumber: Google

Salam semua, dah lama tak update entry di sini, hampir 3 bulan. Idea untuk menulis memang sentiasa ada, cuma agak keterbatasan waktu untuk mengolah agar ayat lebih mudah difahami kepada pembaca.

Juga terima kasih kepada anda yang pernah mendapatkan khidmat dan servis saya, jutaan terima kasih atas kepercayaan yang diberikan.

Sebenarnya adakalanya idea menulis itu datang ketika menjalankan analisis, yang adakalanya saya tak terokai waktu zaman belajar dahulu, namun begitulah mana-mana bidang ilmu, selagi kita teroka dan gali, rasa banyak sangat maklumat yang tidak diketahui. Namun sedikit sebanyak ilmu yang kita dapat mungkin dapat dikongsi dengan orang lain yang tidak berkesempatan untuk menggalinya.


Ok lah untuk entry kali ini, saya nak ceritakan sedikit mengenai perbandingan kaedah putaran dalam analisis faktor, selalunya bila kita guna SPSS > Analyze > Dimention Reduction > Factor Analysis > Rotation. Kaedah rotation yang manakah harus digunakan? Namun dalam entry ini lebih kepada perbandingan antara kaedah varimax dan promax sahaja. Kajian lanjut nanti kita buat paper lah..hehe.


Hampir semua kaedah putaran dalam analisis faktor boleh dibahagikan kepada 2 jenis umum iaitu, ‘orthogonal’ dan ‘oblique’.


Jadual: Perbandingan Putaran Jenis Orthogonal dan Oblique


Analisis dalam kaedah promax menghasilkan putaran struktur yang lebih mudah berbanding Varimax, khususnya apabila ciri-ciri pemboleh ubah pendam (latent) adalah berkorelasi tinggi (McLeod et al., 2001).

McDonald (1997) mencadangkan jenis putaran oblique lebih sesuai kerana dalam aplikasi sebenar, jarang untuk menemui setiap faktor dalam kajian tidak berkorelasi antara satu sama lain.

De Vellis (2003) pula dalam kajiannya mencadangkan apabila korelasi antara faktor adalah <  0.15, jenis orthogonal lebih baik, sebaliknya jika lebih r > 0.15, maka jenis oblique adalah sesuai.

Kieffer (1998) pula mencadangkan menggunakan kedua-dua orthogonal dan oblique, kemudian kedua-dua keputusan dibandingkan. Jika kedua-dua kaedah menghasilkan keputusan yang sama atau tidak banyak beza, orthogonal boleh digunakan. Namun jika terdapat banyak perbezaan, pendekatan oblique lebih sesuai.

(Johnson & Wichem, 2002; McDonald, 1997; Tabachnick & Fidell, 2001) secara umumnya mencadangkan bahawa jika pengkaji percaya bahawa faktor tersembunyi (underlying factor) adalah berkorelasi antara satu sama lain, jenis oblique harus digunakan.

Namun berdasarkan cadangan-cadangan penulis terdahulu, tiada kajian yang betul-betul menguji sejauh mana pencapaian pendekatan orthogonal mahupun oblique mengikut bidang kajian tertentu.  
Oleh kerana putaran faktor tidak mengubah penyuaian (fit) sebenar penyelesaian dalam analisis faktor, tiada satu kaedah yang ada boleh dikatakan lebih baik berbanding yang lain. Sebaliknya, setiap kaedah mempunyai kelebihan dan kekurangan yang unik, di mana sesuatu pendekatan tersebut mungkin lebih sesuai dalam sesetengah keadaan/ kajian tertentu.

Ok, setakat ini dahulu perkongsian hari ini. Ada masa kita cerita lagi.

Artikel ini saya olah daripada:

Finch, H. (2006). Comparison of the Performance of Varimax and Promax Rotations: Factor Structure Recovery for Dichotomous Items. Journal of Educational Measurement, Vol. 43, No. 1 (Spring, 2006), pp. 39-52


Rujukan:
Johnson, R. A., & Wichern, D. W (2002). Applied multivariate statistical analysis. Upper Saddle River, NJ: Prentice Hall.

DeVellis, R. F. (2003). Scale development: Theory and applications. Thousand Oaks, CA: Sage

Kieffer, K. M. (1998). Orthogonal versus oblique rotation: A review of the literature regarding the pros and cons. Paper presented at the Annual Meeting of the Mid-South Educational Research Association, New Orleans, LA, November, 1998.

McDonald, R. P. (1997). Test theory: A unified treatment. Mahwah, NJ: Erlbaum.

McLeod, L. D., Swygert, K. A., & Thissen, D. (2001). Factor analysis for items scored in two categories. In D. Thissen & H. Wainer (Eds.), Test scoring (pp. 189-216). Mahwah, NJ: Erlbaum


Tabachnick, B. G., & Fidell, L. S. (2001). Using multivariate statistics. Needham Heights, MA: Allyn & Bacon.

Monday, 25 September 2017

CERITA 18: Tips Memilih Ujian Statistik yang Sesuai (II)

Salam semua, sebelum ini saya pernah kongsikan di blog Tips Memilih Ujian Satatistik yann Sesuai DI SINI.

Tetapi hari ini saya nak kongsikan tips berdasarkan data Dependent Variable (DV) dan Independent Variable (IV) yang kita ada.


Rujukan:

Annette, J.D.  2002. An Introduction to Generalized Linear Models. Edisi ke-2. Florida: Chapman & Hall/CRC.

Wednesday, 12 July 2017

CERITA 17: Multicollinearity Dalam Data

 Multikolineariti (multicollienarity) 

sumber: google

Multikolineariti adalah keadaan di mana korelasi antara pasangan pemboleh ubah tidak bersandar yang sangat tinggi (r = 0.9 dan ke atas). Oleh itu, multikolineariti ditakrifkan sebagai sejenis gangguan dalam data, dan jika ia wujud, dapatan statistik yang didapati berkemungkinan tidak boleh dipercayai.

Kewujudan masalah multikolineariti perlu dilakukan sebagai salah satu langkah awal dalam data kita sebelum melakukan analisis lanjut seperti analisis regresi berganda (mutliple linear regression - MLR). Jika anda berhasrat untuk menggunakan MLR dalam kajian, anda seharusnya peka dengan isu ini dan melakukan ‘usaha’ lanjut bagi mengatasi masalah ini.


Tanda-tanda kewujudan multikolineariti 
  •  Apabila kita menambah atau membuang pemboleh ubah tidak bersandar, nilai pekali regresi akan berubah dengan ketara
  • Ralat piawai bagi pekali regresi menjadi besar
  • Pekali regresi sesuatu pemboleh ubah tidak bersandar akan menjadi tidak signifikan walaupun keseluruhan model adalah signifikan
  • Sesetengah pekali regresi berkemungkinan akan berbeza secara signifikan daripada apa yang dijangka (walaupun mempunyai tanda yang berbeza)
  • Nilai korelasi antara pasangan pemboleh ubah tidak bersandar adalah tinggi


Penyebab multikolineariti
  •  Pensampelan: kita hanya mengambil sampel kawasan yang mempunyai pemboleh ubah tidak bersandar berkorelasi
  • Model (atau populasi) tersebut memerlukan beberapa pemboleh ubah tertentu mempunyai korelasi
  • Tidak menggunakan model yang terbaik


Bagaimana untuk kenal pasti multikolineariti?
  1. Matriks korelasi 
  2. Variance Inflation Factor (VIF) 
  3. VIF mengukur kesan kolineariti antara pemboleh ubah dalam model regresi. Nilai VIF lazimnya ≥1. Dalam kajian literasi, terdapat beberapa cadangan digunakan untuk nilai VIF yang diterima. Tetapi secara kebiasaannya, nilai VIF = 10 dicadangkan sebagai nilai maksimum menandakan multikolineariti wujud (iaitu Hair, Anderson, Tatham, & Black, 1995; Kennedy, 1992; Marquardt, 1970; Neter, Wasserman, & Kutner, 1989). Namun, ada juga kajian menyarankan 5 sebagai nilai maksimum (cth: Rogerson, 2001) malah nilai 4 (cth: Pan & Jackson, 2008) 
     3. Tolerance 
     4. Eigensystem analysis 


Bagaimana berhadapan dengan masalah multikolineariti?
  1.       .. Membuang pemboleh ubah yang mempunyai korelasi yang tinggi dalam model
  2.   ..Menggunakan kaedah Partial Lease Square Regression (PLS) atau Principal Component Analysis (PCA)


Rujukan:
● Hair, J. F. Jr., Anderson, R. E., Tatham, R. L. & Black, W. C. (1995). Multivariate Data Analysis (3rd ed). New York: Macmillan.
● Kennedy, P. (1992). A Guide to Econometrics. Oxford: Blackwell.
●Marquardt, D. W. (1970). Generalized inverses, ridge regression, biased linear estimation, and nonlinear estimation. Technometrics, 12, 591–256.
● Neter, J., Wasserman, W. & Kutner, M. H. (1989). Applied Linear Regression Models. Homewood, IL: Irwin.
● Pan, Y, & Jackson, R. T. (2008). Ethnic difference in the relationship between acute inflammation and and serum ferritin in US adult males. Epidemiology and Infection, 136, 421-431.
● Rogerson, P. A. (2001). Statistical methods for geography. London: Sage.


Thursday, 6 July 2017

CERITA 16: Penjelmaan Data (Data Transformation)

Penjelmaan Data (Data Transformation)


Salam semua pembaca yang budiman, wahh bila mood R.A.J.I.N datang menjelma, hari-hari ko update blog.hehe. Ok kalau nak tau untuk semua pembaca, setiap entry yang ditulis adalah melalui pemahaman dan pembacaan saya di beberapa blog/ website/ jurnal di internet.

Juga hasil rujukan daripada beberapa buah buku. Adakalanya saya ambil ringkas sahaja kerana untuk rujukan saya juga, maklumlah adakalanya kita juga mudah terlupa dan blog ini adalah salah satu catatan ringkas saya secara santai.

*Flashback kejap* 
Ok tajuk di atas ni sebenarnya mengingatkan saya memori sewaktu buat degree dulu di Institut Sains Matematik, Fakulti Sains, Universiti Malaya. Banyak kenangan di situ, tambahan pula 12 tahun dahulu, pelajar Melayu yang ambil statistik berapa kerat sahaja. Dan salah satu subjek yang saya gemari adalah Analisis Data, waktu tu antara pensyarah favourite saya dan geng adalah Dr. Ibrahim Mohamed, sekarang beliau dah bergelar Prof. Dr. Ibrahim Mohamed, ;). Tahniah Prof! Juga antara pensyarah yang kurus, tinggi, lawa mengajar subjek Design of Experiment (DOE), Prof. Dr. Aishah Hamzah. Setiap hari nak pergi kelas sebab suka tengok gaya beliau yang tak pernah tak cantik! hehe . maklumlah student2 nya selebet sahaja. 


Kembali kepada penjelmaan data

Ok, balik kepada realiti. Masa bila perlunya kita buat data transformation ni? Ok, setelah kita melihat bentuk taburan data melalui beberapa kaedah visual sebelum ni, seperti histogram/ plot normal, adakalanya bentuknya tidak menyerupai loceng atau berbentuk taburan normal. Sebagai perbandingan, bentuknya seperti di bawah:

sumber: google


Jika data kita mengikuti bentuk taburan normal, seharusnya nilai min=median=mode adalah sama.


Walaubagaimanapun, adakalanya kita mendapat bentuk seperti yang di bahagian tengah (positive skew- pencong ke kanan) atau (negative skew- pencong ke kiri).

Bagaimana untuk atasi masalah ini?

Seperti yang diketahui, kaedah statistik berparameter (parametric) memerlukan andaian kenormalan. Jika tidak, kaedah statistik tak berparameter (non-parametric statistic) mungkin menjadi pilihan anda.


Antara kaedah penjelmaan data yang popular:

1. Square-root transformation 
    - jika varians berkadaran dengan nilai min
    - sesuai untuk data berbentuk bilangan (count data)
 

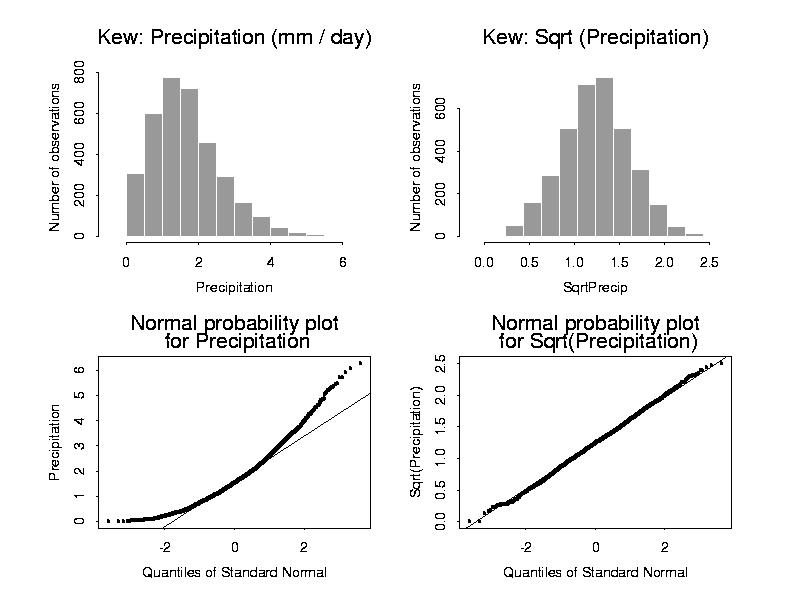
Jika kita lihat bentuk taburan data asal kelihatan pencong ke kanan, setelah kita lakukan square-root transformation, bentuk taburan menjadi taburan normal.


2. Log transformation
    - jika sisihan piawai berkadaran dengan nilai min
    - untuk taburan berbentuk pencong ke kanan


3. Reciprocal transformation
    - jika sisihan piawai berkadaran dengan nilai min kuasa dua


OK..sampai sini dulu.. jika rajin akan update lagi. tkasih sudi membaca.